
DOC OPS.
AI-помічник по документах: рахунок, прайс або скан постачальника перетворюється на перевірену таблицю. OCR, вилучення за схемою, арифметика, ПДВ, дублі та експорт — з людиною на перевірці.
Роль
Продукт, бекенд, UI, деплой
Рік
2026
Статус
Live demo · 2026
Публічне демо на синтетичних документах. Завантажені файли видаляються через 24 години; реальні клієнтські дані не використовуються.
44
документи в бенчмарку
99.6%
точність полів
97.7%
документів без помилок
5.8с
медіана на документ
Помилку видно до того, як вона потрапила в облік
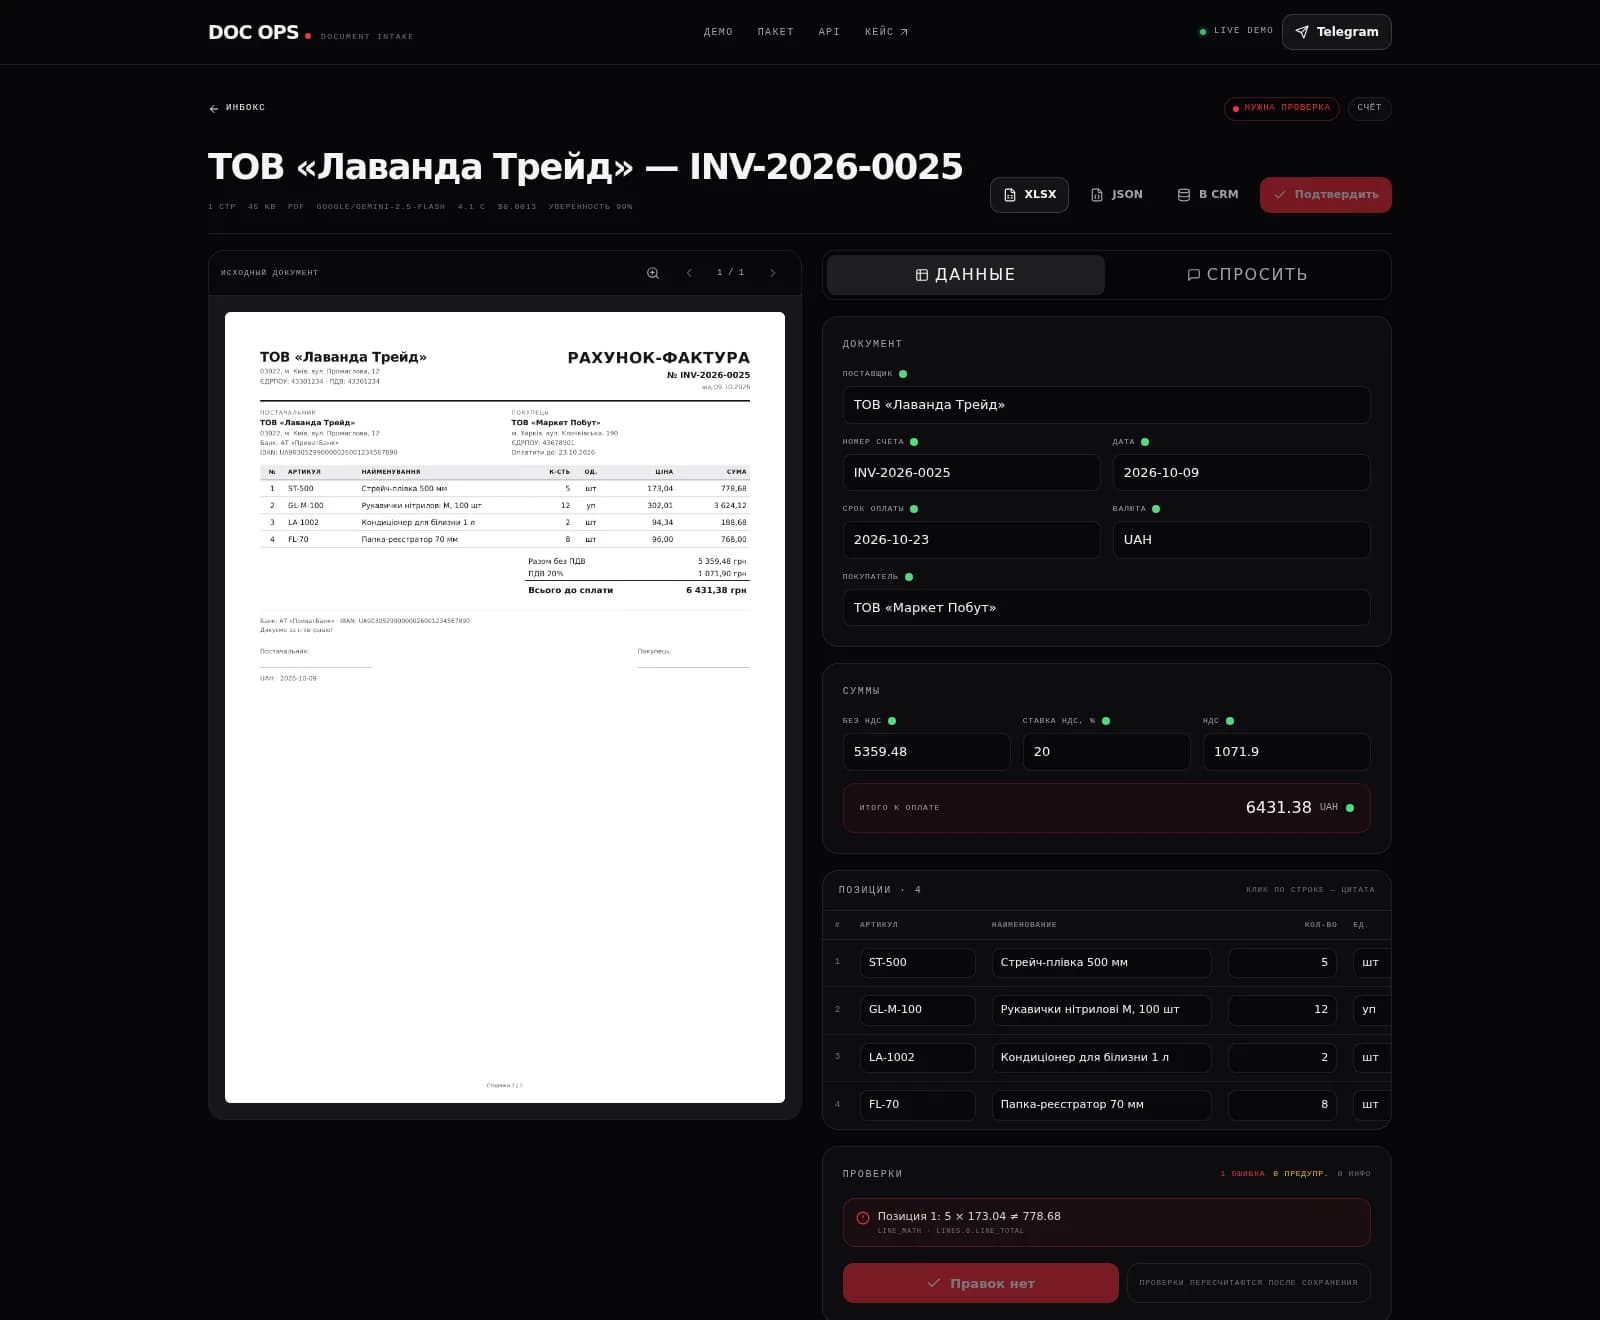
Модель вилучає дані, але не вирішує, чи можна їм вірити. Арифметику, ПДВ, дати та дублі перевіряє окремий детермінований шар. На демо-наборі він упіймав усі три спеціально зламані сценарії.
3/3
edge-case упіймано
0.2с
XLSX без моделі
24год
життя файлу
Задача
Оптова команда отримує десятки рахунків і прайсів у PDF, сканах і Excel. Позиції переносять руками: 3–5 хвилин на документ, помилки в сумах, повторні завантаження й жодного аудиту. Звичайний «чат із PDF» тут не допомагає: потрібні рядки в таблиці, а не відповіді.
Рішення
Конвеєр document intake: файл → текст або OCR → тип → вилучення за суворою JSON-схемою → перевірки → екран перевірки → XLSX / JSON / CRM. Модель заповнює поля, людина підтверджує спірні, детермінований шар ловить арифметику та дублі.
П'ять кроків, один результат
Кожен крок можна перевірити окремо: текст, тип, поля, перевірки, рішення людини.
Ingest
PDF, JPG/PNG, DOCX, XLSX. Перевірка MIME і розміру, sha256, прев'ю сторінок, ліміт 20 сторінок.
Текст і OCR
Текстовий шар через pdftotext; скани й фото — vision-модель. XLSX читається детерміновано, без LLM.
Вилучення
Класифікація типу та JSON за схемою: постачальник, номер, дати, суми, усі позиції. Zod і один retry з текстом помилки.
Перевірки
Кількість × ціна, сума позицій, ПДВ, підсумок, дублі номера, діапазон дат, обов'язкові поля.
Перевірка та експорт
Підсвітка низької впевненості й цитат, inline-правки, підтвердження, XLSX/CSV/JSON і вебхук.
const source = await readSource(doc);          // text | vision
const type = await classifyDocument(source);  // invoice | price_list
const result = await extractDocument(type, source); // JSON + Zod retry

const checks = validateExtraction(result.data, doc.id);
const status = checks.some((c) => c.severity === "error")
  ? "needs_review"
  : "done";

// arithmetic, VAT, dates, duplicate number —
// deterministic rules, not another model call
Стек
Вилучення й перевірки розділені: LLM не вирішує, чи сходиться арифметика. Тому помилку можна пояснити й відтворити.
Рішення
Schema-first, не вільний чат
Модель заповнює типізовану схему, а не відповідає текстом. Результат можна валідувати, порівнювати й експортувати.
Детермінована валідація
Арифметика, ПДВ, дати й дублі — звичайний TypeScript. Це пояснювано, відтворювано й не залежить від температури моделі.
Human-in-the-loop
Confidence за полями, блокери й попередження. Нижче порогу документ не рухається далі без підтвердження людиною.
Excel без моделі
Прайси в XLSX розбираються кодом: заголовки, колонки, числа. 0.2 секунди й нульова вартість за документ.
Можливості
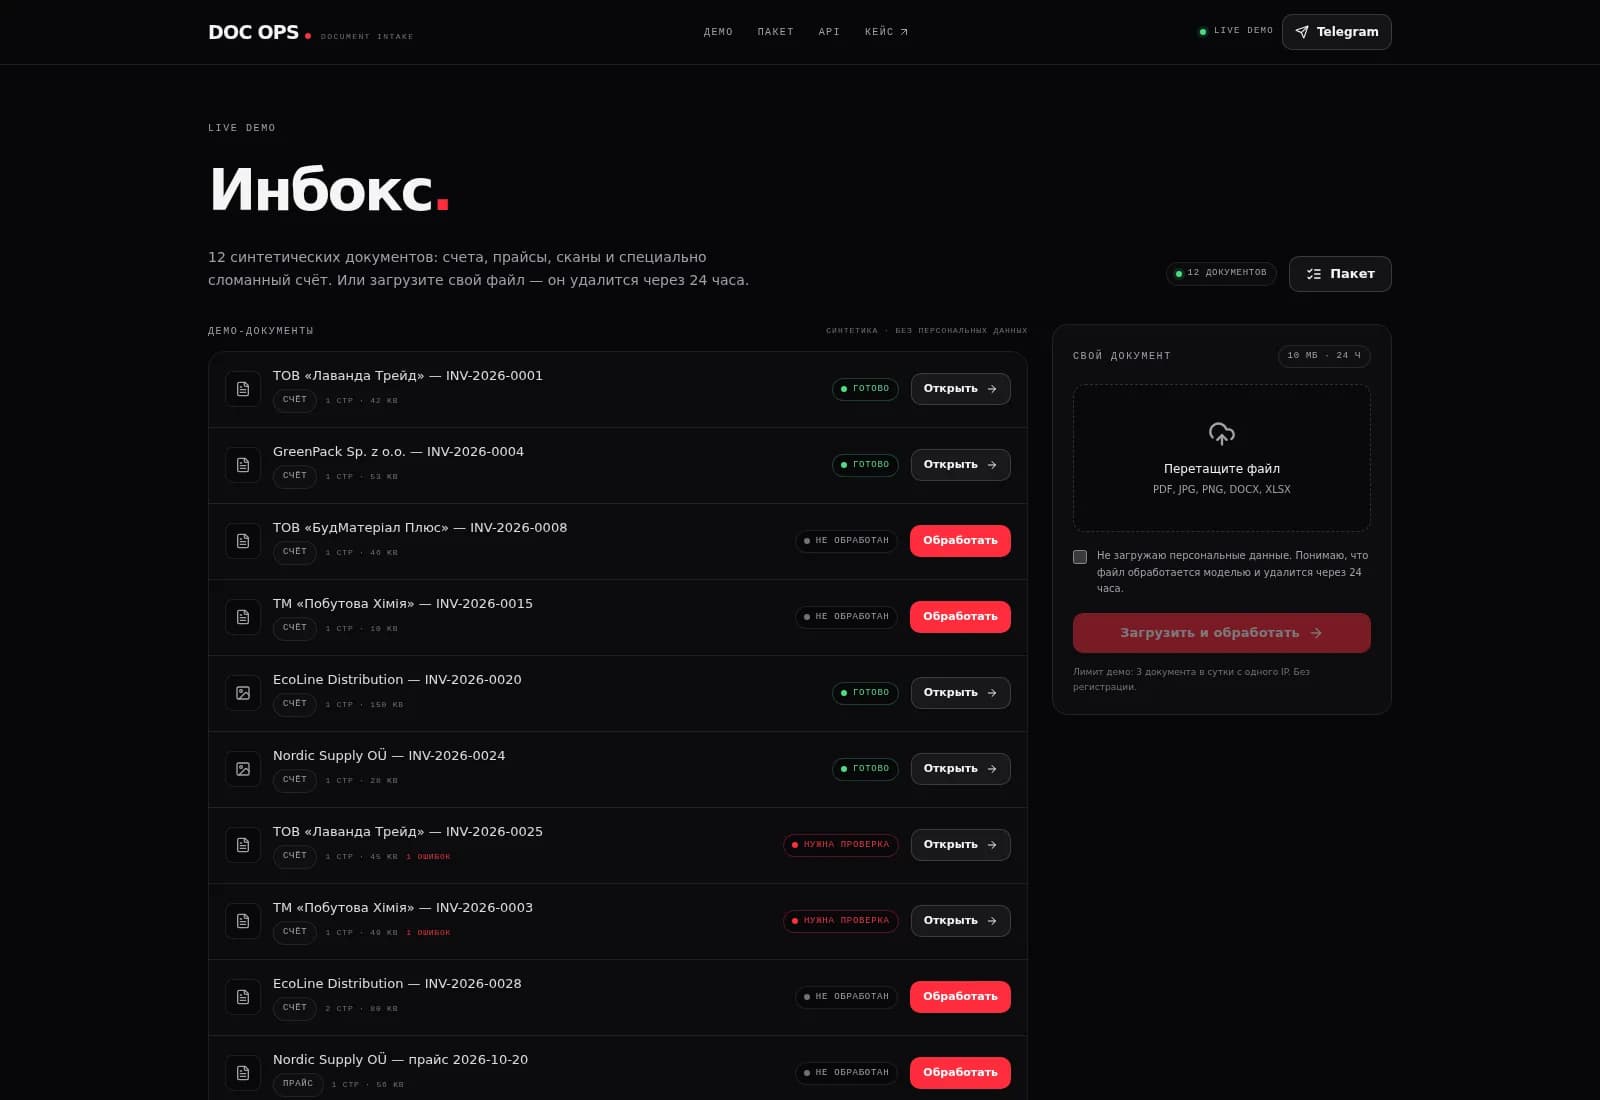
Рахунок, прайс, скан, DOCX і XLSX
OCR і vision для фото
Позиції, суми, ПДВ і валюта
Перевірка арифметики й дублів
Confidence і цитати сторінок
Inline-правки й підтвердження
Експорт XLSX / CSV / JSON
Публічний демо-API
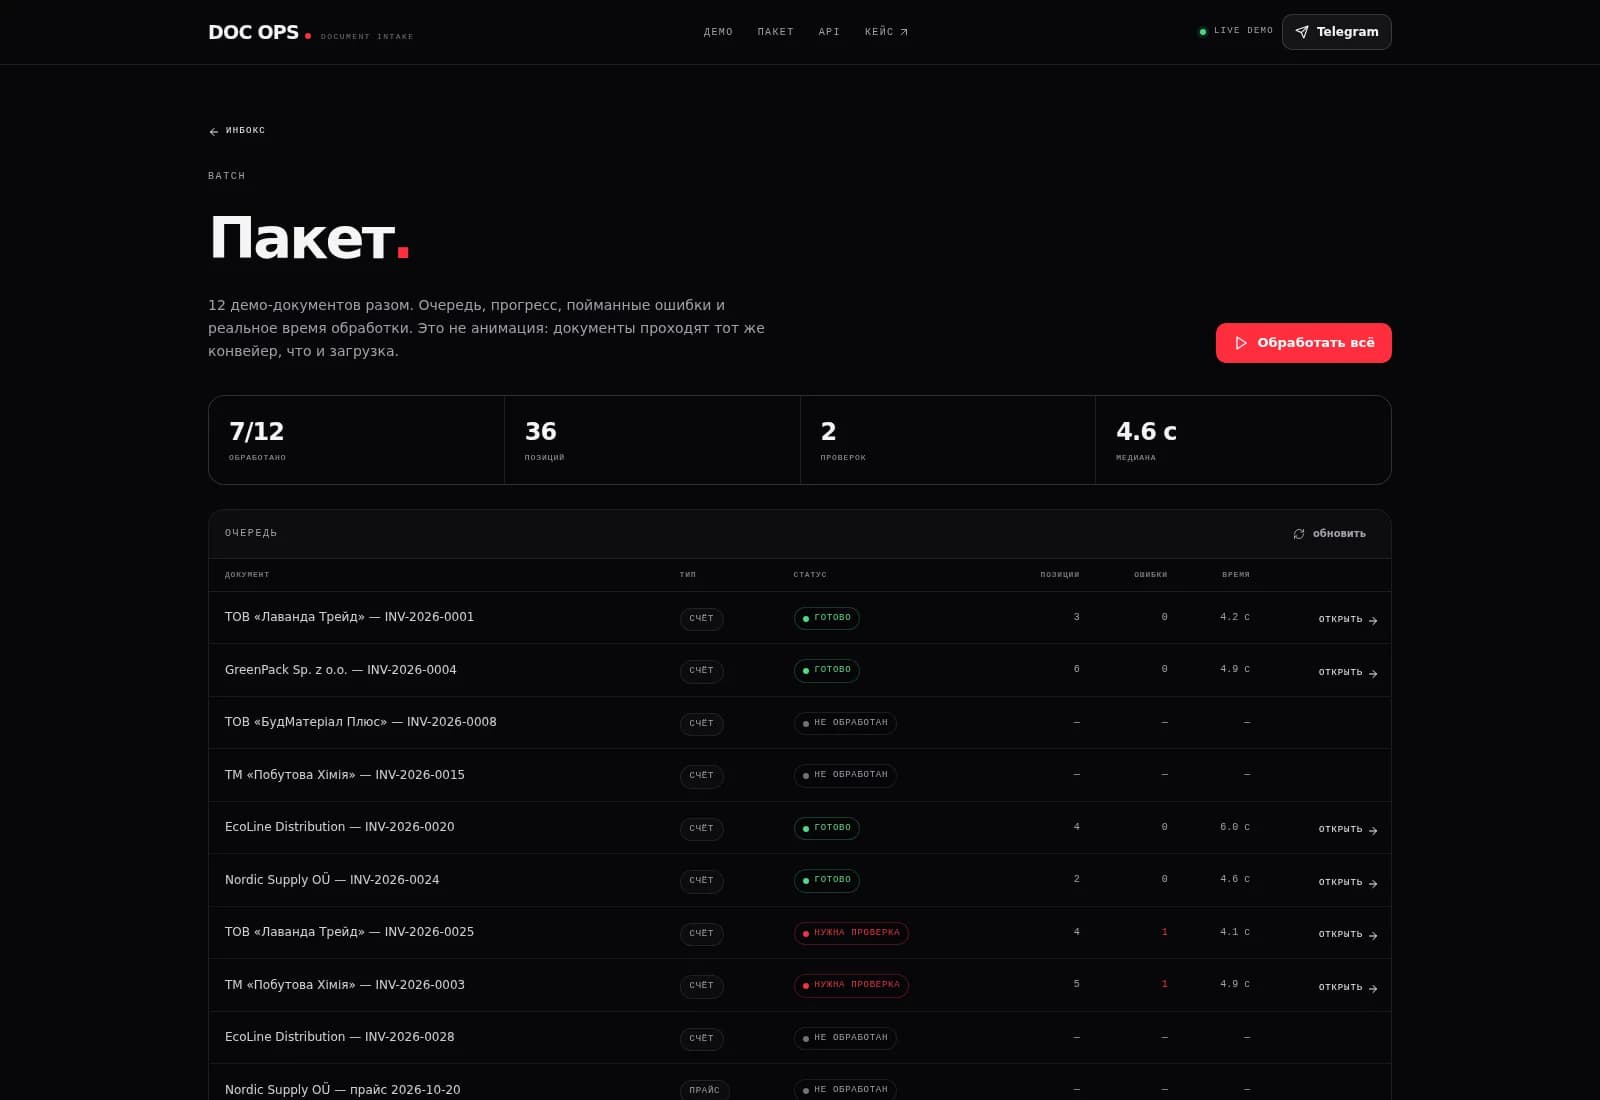
Пакетна обробка
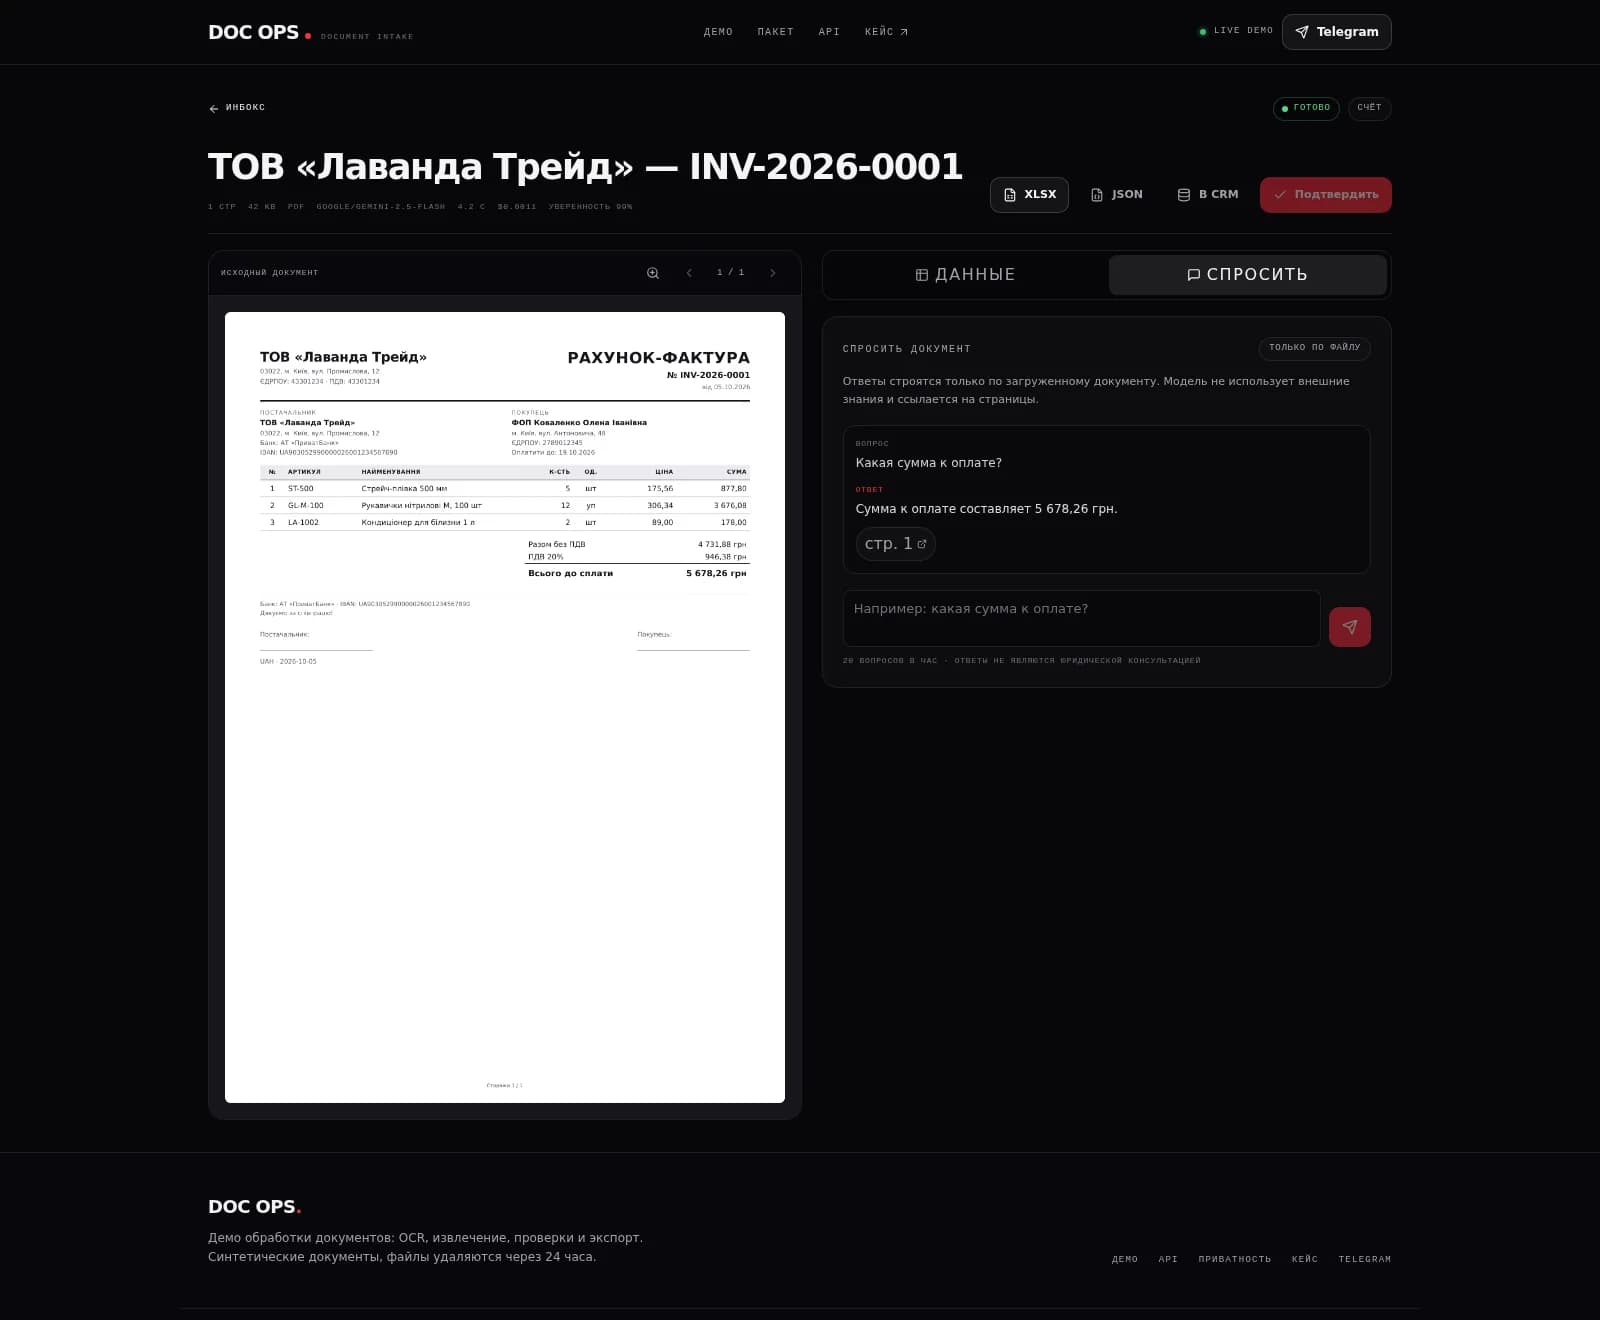
Питання за документом
Ліміти 3/добу й TTL 24 год
Документи RU / EN / UK
Інтерфейс
Реальні скриншоти демо: інбокс, перевірка, пакет і питання за документом.
Бенчмарк
44 синтетичні документи з ground truth: текстові PDF, скани, DOCX, XLSX і спеціально зламані рахунки. Цифри отримані скриптом, а не вручну. Два прогони: 43–44 з 44 документів повністю.
99.6%
Точність полів
100%
Точність позицій
43 / 44
Документів повністю
5.8 с
Медіана на документ
$0.0015
Оцінка вартості
3 / 3
Edge-cases упіймано
Потрібен розбір документів під ваш процес?
Покажу, як вбудувати конвеєр у CRM, 1С або n8n: від приймання файлу до перевірки людиною та експорту.